RoundingSAT 阅读笔记其一
Divide and Conquer: Towards Faster Pseudo-Boolean Solving#
简介#
SAT 的局限性
CDCL 的推理(reasoning)能力差,因为其推理能力主要基于归结证明;以及其表达能力有限,只能解决以 CNF 形式表达的问题(虽然都可以规约,但会引入很多子句和变量),虽然有很多预处理技术(高斯消元,基数推理)可以提高很多速度,但这都与编码方式有很大关系,有时候并不是很有效果
由于 SAT 具有很大的局限性,于是,我们转向使用线性伪布尔约束来描述问题,这种约束形式能够表达比 CNF 更多的信息,但结构又与 CNF 很相似,于是基于 CNF 的技术可以应用到 PB 上
一些 PB 求解器仍然是基于归结的,这些求解器会将输入转化为 CNF,再进行求解;主要有两类做法:
eagerly:先转化为 CNF,然后直接调用 CDCL 求解器求解,代表是 MiniSat+,Open-WBO,NaPSlazily:在修改的 CDCL 求解器中,保持输入的 PB 格式,但仅以子句的形式导出新的信息,代表为 Sat4j
另一种做法是使用切平面法来解决 PB 问题,但这种做法需要将 CDCL 框架拓展到 PB 上,这是十分困难的。
从理论的观点来看,使用切割平面似乎是很可取的,因为这种方法从来不比归结差,甚至可以做到指数级的更强。然而,实际上并非如此,通常基于 CDCL 的求解器优于基于切平面法的 PB 求解器。
在这篇文章中,提出了一个基于 CDCL 的 PB 求解器 RoundingSAT
基于冲突分析的 PB 求解#
首先,我们回顾 PB 约束的标准形式:
\sum_i c_i \cdot l_i \geq w其中,
我们将部分真值赋值
一个传统的 CDCL 框架如下图所示:
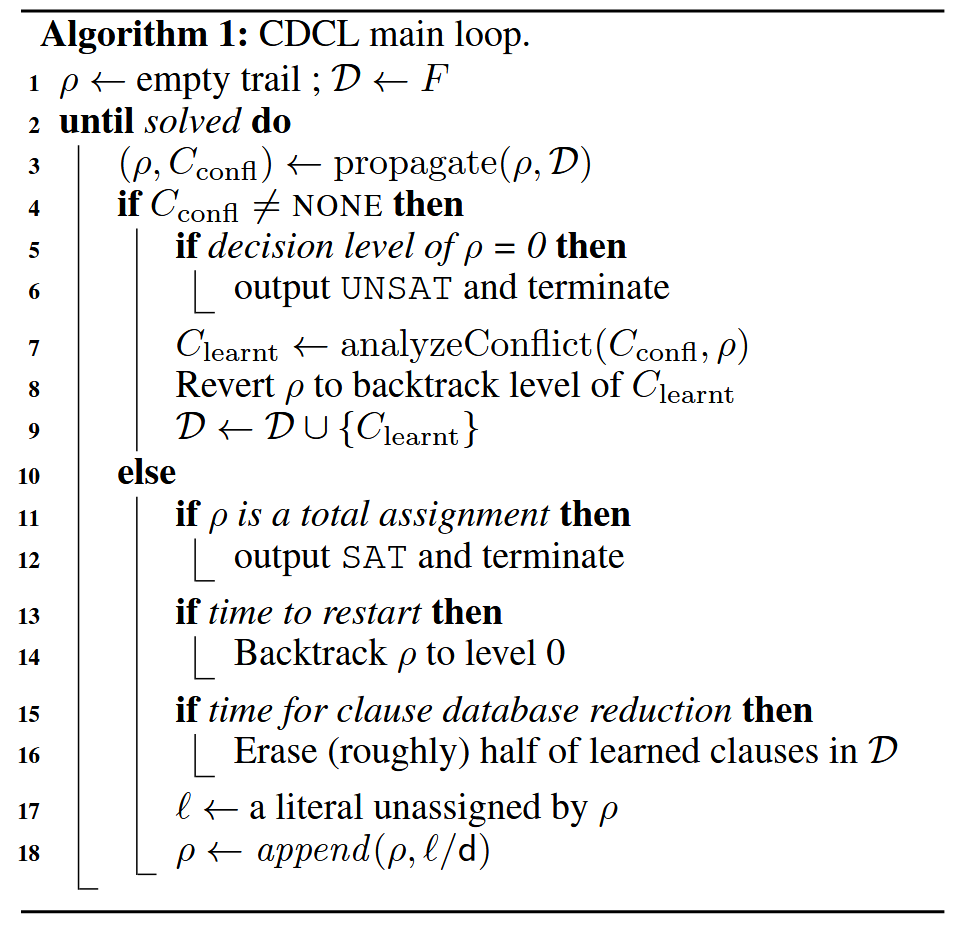
在这里,我们不详细解释 CDCL 是如何工作的,我们希望做的是将 CDCL 中的两个重要部件引入到 PB 中来(重启与子句库之类的技术不在本文的探讨范围内)
单元传播#
在 SAT 中,对于任意一条子句,只要有一个文字为真,子句即可为真,因此我们可以很轻松的进行单元传播,而在 PB 中,这种简单的成真条件不存在了,于是我们需要重新考虑传播的方案
首先,我们引入一个记号,对于任意一条约束
slack(C, \rho) = \sum_{i\colon \rho(l_i) \not= 0}c_i - w可以发现
显然当
如果文字
冲突分析#
分析的方法是使用广义归结来进行,其定义如下:
给定一对存在冲突的约束
\frac{b}{g}\sum_ic_i\cdot l_i + \frac{a}{g}\sum_i c_i^\prime \cdot l_i^\prime \geq \frac{bw + aw^\prime -ab}{g}随后,我们反复回退决策层,试图找到最早的那次冲突决策点,从而得到学习子句(这也是 CDCL 中 1UIP 的做法)
存在的问题#
我们考虑以下例子,
随后,在单元传播时,我们会在
弱化与饱和#
我们通过两个算子,
弱化#
例如对于约束
可以发现,弱化操作就是直接将某个文字的取值假定为真
饱和#
例如对于约束
最终的冲突分析#
于是,最终的冲突分析如下所示:
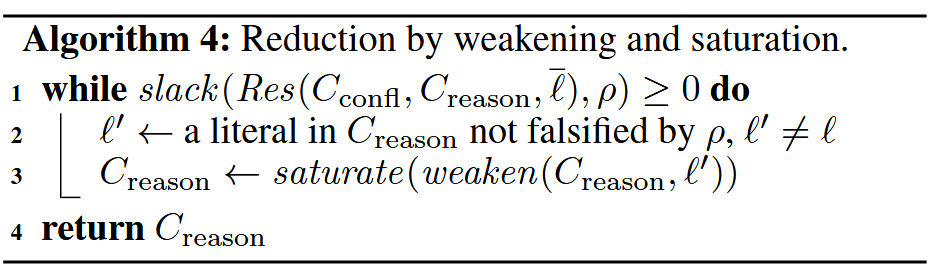
一个简单的分析示例
考虑两个约束
假设此时的 trail 为
- 对于 trail 中的最后一个文字,我们有
,其 ,于是我们进行归结 - 我们在原因约束中选择一个不同于
的不导致冲突的文字,例如 ,接着我们做弱化与饱和操作,得到新的原因约束: ,其中饱和操作没有任何影响,因为 为真 - 接着,我们得到新一轮的归结
,此归结的 ,于是我们继续进行归结 - 下一个被选择的文字为
,我们得到新的原因约束为 ,此时归结的 ,其 ,于是继续归结 - 下一个被选择的为
,得到新的原因约束为 ,于是归结为 ,此时的 ,结束循环
最终,我们得到的
值得注意的是,我们并没有真正的计算
slack(C + C^\prime, \rho) \leq slack(C, \rho) + slack(C^\prime, \rho)基于 Division 的冲突分析#
我们将饱和算子替换为分割算子,其工作原理如下所示:
divide(C, d) \colon \sum_i \lceil c_i/d \rceil\cdot l_i \geq \lceil w/d \rceil其中
RoundToOne#
首先外面介绍一个组件算法,RoundToOne,其流程如下图所示:
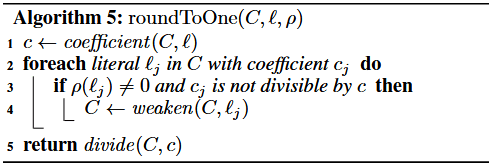
其接受一条约束
对于任意 trail
slack(\text{roundingToOne}(C, l_i, \rho), \rho) = \lfloor slack(C, \rho)/c_i \rfloor于是,我们有推论:
若一条约束
RoundToOne 的示例
考虑两个约束
- 我们求得
的系数为 ,随后开始迭代 - 由于
均不是成假的,因此我们进入第二步判断,而由于只有 的系数无法整除 ,于是, 被弱化,我们得到了约束 ,此时循环结束 - 最后,我们通过分割算子得到了以下约束:
此时,我们得到了一个比原来的方案更强的约束(原来的约束为
RoundToOne 的变形
考虑
但如果我们不在一次执行让所有满足条件的文字弱化,而是让算法每次在某一个文字上弱化,并且在分割后的
然而,可以证明,无论进行弱化的顺序如何,这种迭代方法总是会弱化几乎和 roundToOne 一样多的文字;更准确地说,区别至多是
另一种变形是在文字上做部分弱化,例如,从
RoundingSAT 冲突分析#
我们的冲突分析算法如下所示:
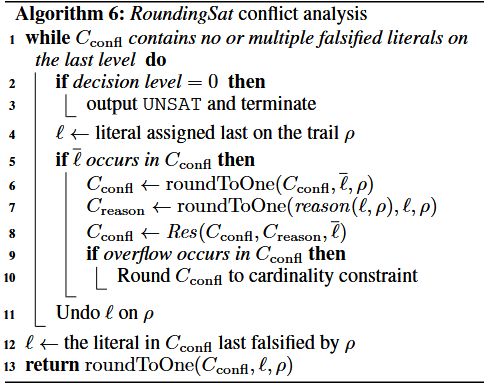
PB 冲突分析中存在一些特殊情况,使其比 CDCL 更加复杂
-
一个归结操作可能会取消当前决策层的所有赋假文字,在这种情况下,分析可能会继续到更早的决策层,甚至可能发生冲突分析能够进行到最高决策层,从而推导出实例是不可满足的
-
学习到的约束可能在其断言(激活)级别1被违反,在这种情况下,在调用单元传播之前会重复执行冲突分析。
实验#
这部分,对比了算法:
- Sat4j
- Open-WBO
- Sat4jRes+CP(使用了切平面法的 Sat4j)
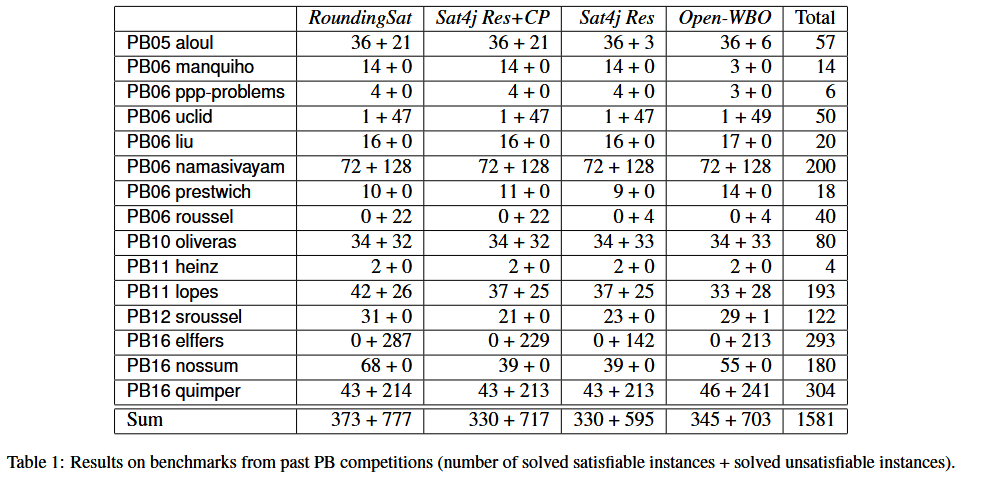
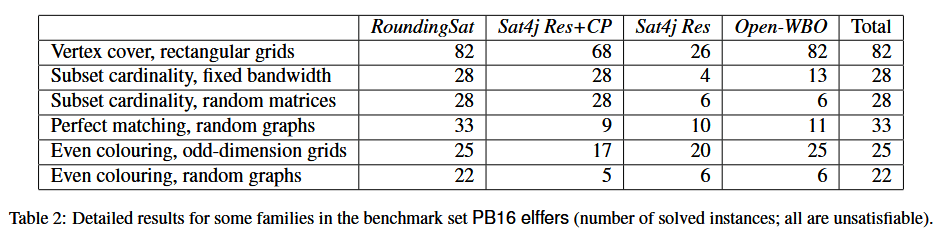
Benchmark 为 PB 竞赛的例子,分类为 DEC-SMALLINT-LIN
结果如下图所示:
未来工作#
一个明显方向是进一步改进我们的求解器。与其他伪布尔求解器一样,RoundingSat 对输入格式很敏感,在 CNF 公式上表现很差。
解决这一问题的一种方法是在可能的情况下将 CNF 重写为更有效的线性约束的规则;特别地,一个重要的挑战是对编码基数约束的子句集合进行 该内容未公开或不可用
脚注#
-
断言级别(Assertion Level) 是冲突驱动子句学习(CDCL)SAT 求解器中的一个重要概念,用于描述在搜索过程中某个约束(或子句)被“断言”或“激活”的决策级别。它表示在搜索树的某个特定层次上,某个约束开始对当前的变量赋值产生影响。 ↩
讨论
想法、补充,或只是打个招呼。