线性回归第一讲
一个老生常谈的话题,似乎每次学习都是从这个地方开始的(而且没继续深入过)。但是线性回归是一个很重要的内容,在谈线性回归之前,我想写解释一下什么是回归。
回归与分类#
机器学习的任务有三种,回归,分类与聚类。我们暂且不管聚类(后面会提到),对于回归与分类,这两个任务的区别在哪?
这样说可能有些抽象,我们举一个实际的例子:预测房价。
-
Description
给你一堆关于 房子面积, 房子楼层, 房子区域 等等等等的数值化后的数据,想要你解决两个问题:
- 给你任意的关于一个房子的数据,判断这个房子属于什么类型的(学区房还是其他的各种类型)
- 给你任意的关于一个房子的数据,判断这个房子的价格是多少
显然,第一个问题是一个典型的分类问题,第二个是典型的回归。
那么他们的区别在哪?
仔细想想可以发现,两种问题的输入是完全一样的,模型可能用的也差不多,那么问题就出在输出上面了。
我们知道分类的输出一定是 当前这个样本属于的类别 ,而类别我们通常使用
线性回归#
通俗来说,回归就是预测输入变量与输出变量之间的关系,等价于函数的拟合。线性回归是回归中的一个特殊的问题,意味着输入变量与输出变量之间存在线性关系。形式化的说法就是:
y = f(x) = b + w^Tx其中
我们的任务,就是使用给定的
参数的计算方法#
那么,如何计算出
我们知道,我们通过一个
一般而言,我们定义
Loss(w, b) = \frac{1}{2N} \sum^N_{i=1}(f(x_i) - y_i)^2 = \frac{1}{2N} \sum^N_{i=1}(b + w^Tx_i - y_i)^2其中,
我们可以发现
w^*, b^* = \mathop{\arg\min}\limits_{w, b}\ Loss(w, b)于是问题就转变成,如何求出
梯度下降#
我们使用迭代法来求解最小值(因为很多函数不一定有解析解)。
我们知道,函数在某一点的梯度是其变化率最快的方向,但这个方向应当如何选择,才能保证我们每次走的都是往最小值的方向走的呢?
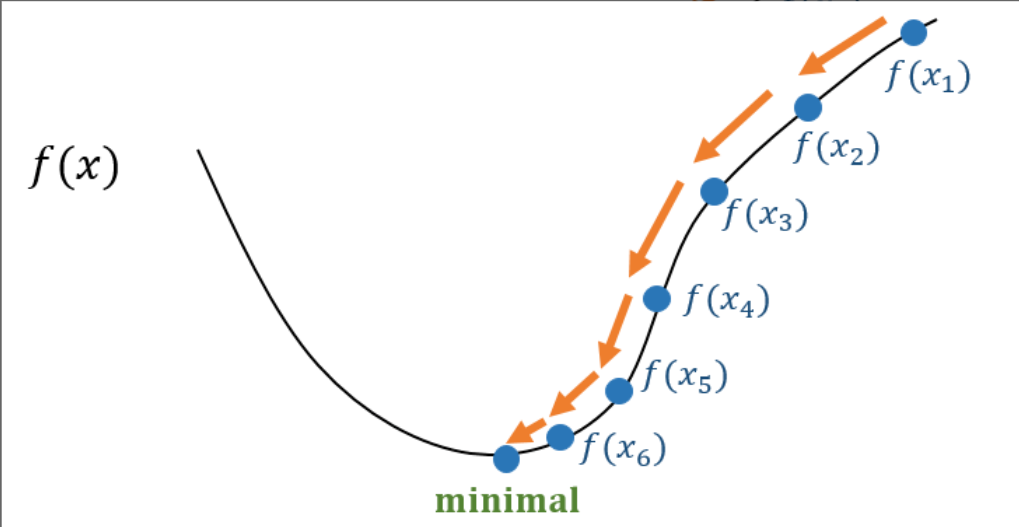
我们不妨假设
根据泰勒公式:
f(x + \Delta x) \sim f(x) + \Delta x\times \nabla f(x)左边是
f(x + \Delta x) < f(x)那么我们就需要保证:
\Delta x \times \nabla f(x) < 0因此,我们取
从而保证了
\Delta x \times \nabla f(x) = -\alpha (\nabla f(x))^2 < 0那么我们就有:
也就是说,我们每次需要移动的一小步,就是
这样就得到了我们的梯度下降算法:
我们假设迭代函数为
- 计算当前点位函数的梯度
- 令
直到
其中,Hyperparameter),指在机器学习任务中需要人为设定的调优参数。
线性回归任务#
于是,我们通过梯度下降最终能够求得
| 1 | 1 | 3 |
| 2 | 1 | 5 |
| 3 | 4 | 8 |
我们假设模型为
那么构造
于是
\begin{aligned}
\nabla Loss &=\left(\frac{\partial Loss}{\partial w}, \frac{\partial Loss}{\partial b}\right)\\
&= (\frac{1}{3}\sum^3_{i=1}x_i(b + w^Tx_i - y_i), \frac{1}{3}\sum^3_{i=1}(b+w^Tx_i - y_i))
\end{aligned}
我们将第
于是我们有:
(w^{(2)}, b^{(2)}) \leftarrow (w^{(1)}, b^{(1)}) - \alpha \nabla Loss(w^{(1)}, b^{(1)})(w^{(2)}, b^{(2)}) \leftarrow (0, 0) - (\frac{1}{3}\sum^3_{i=1}x_i(- y_i), \frac{1}{3}\sum^3_{i=1}(- y_i))(w^{(2)}, b^{(2)}) \leftarrow ((\frac{37}{3},\frac{40}{3}), \frac{16}{3})如此反复迭代,直到
非线性回归#
这里介绍一种较为简单的非线性回归——多项式回归
如下图所示:
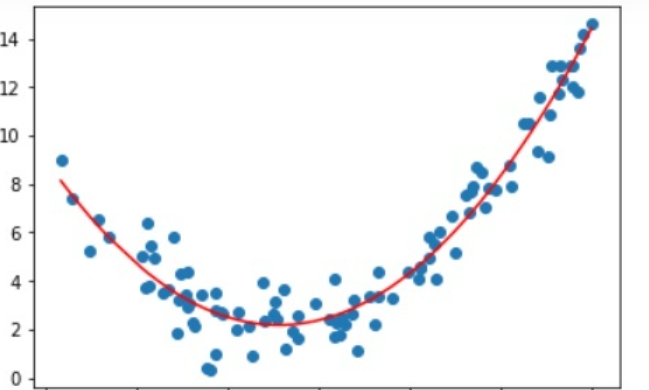
类似这样的数据,我们无法通过类似
升维#
如上图的曲线,从肉眼来看,大概率是一个二次曲线,那么我们应该假设模型为
类似的,对于更加复杂的图像,可能二次曲线也不能描述,那么我们就会继续升维,构造
然而,多项式回归也可以转化成线性回归的形式:
我们可以构造一个线性映射
我们构造的映射
如此,
easy
过拟合与欠拟合#
在多项式回归中,这两个是经常遇见的问题。原因在于,我们事先并不知道
如果我们
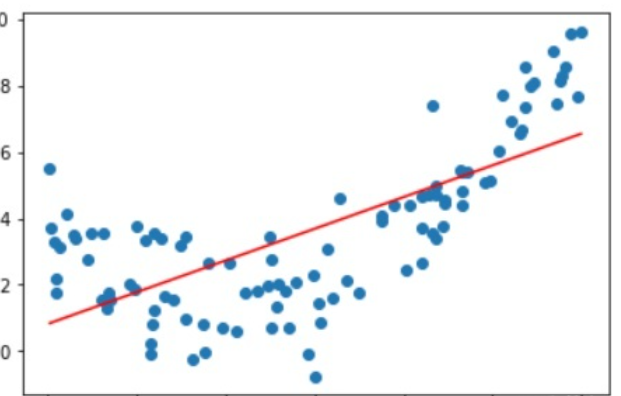
而如果我们的
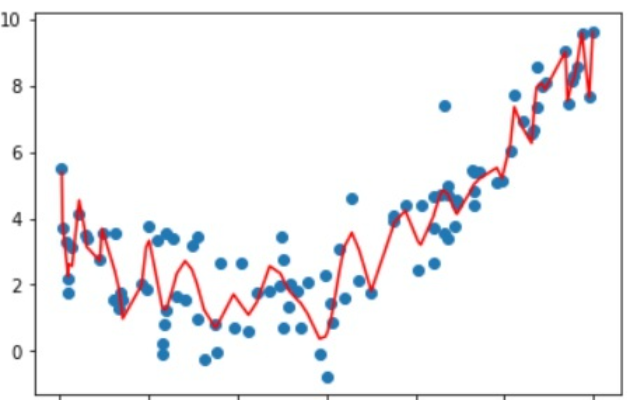
你可能会觉得,第一种情况确实拉跨,但第二种情况的表现不是很好吗?
在某种意义上,第二种模型的表现确实很好,他把数据集中所有点的特征都考虑到了,不管高的低的全部都能覆盖到。但我们知道,数据集并不是干净的,也就是说,在数据中存在 噪声点,噪声点是干扰信息,并不能很好的反映数据真实的特征,因此我们应当将其忽略。
但如果你的模型发生了过拟合,那么模型就会被噪声点干扰,从而呈现出训练集上表现很好,但测试集上表现很差的情况
那么我们如何避免这两种情况的发生呢?
-
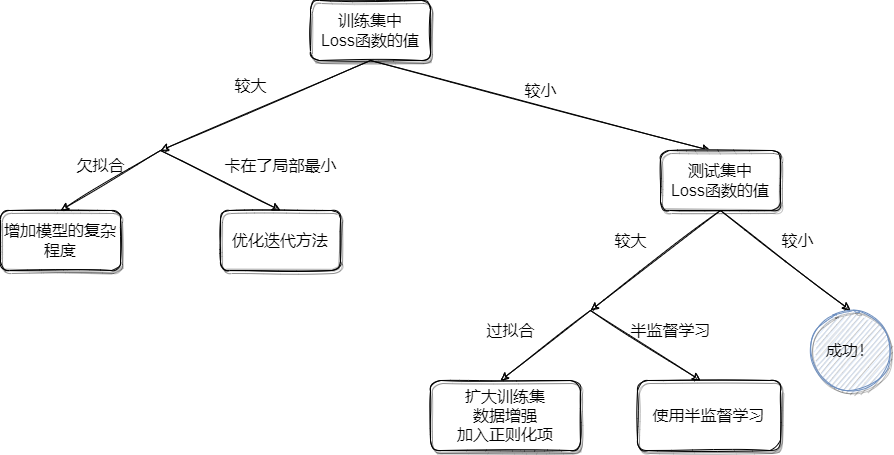
欠拟合是显然的,我们只需要升维!升维!或者说,我们只需要增加训练次数,增加模型的复杂程度即可。
-
在机器学习任务中,主要解决的都是过拟合问题。因为我们希望,我们的模型不仅仅是在训练集上跑得好,我们希望他在测试集,验证集,甚至是实际应用中都能够有不错的成绩(这种能力被称为泛化能力)
那么,为了解决过拟合问题,我们主要有三种方法:
-
更多的训练数据。有些时候过拟合可能是因为数据集太小,训练来训练去也只有那几个数据在掰扯,没有意义。所以我们可以通过增大训练集,通俗一些,就是我们可以让模型多学一点,把东西都学完,这样不管遇到什么情况,他在测试集上的表现一定不会差。
-
数据增强。这部分会在后面的
CNN中提到 -
让模型更简单。在多项式回归中就是说,我们需要适当的减小
。具体而言,我们将更改 的定义。 我们定义
函数为 Loss(w, b) =\frac{1}{2N} \sum^N_{i=1}(f(x_i) - y_i)^2 + \lambda J(f)其中
为模型的复杂程度,被称为 正则化项 通过这样定义
函数,我们可以将模型的复杂程度与拟合程度统筹考虑。这种类型的 函数被称为结构风险最小化
-
总结#
如图:
讨论
想法、补充,或只是打个招呼。